Vom Jira-Ticket zum Merge Request: Eine KI-Pipeline mit Claude Code
Wie Claude Code in einem echten Projekt Tickets liest, umsetzt, testet, Screenshots anhängt und Merge Requests öffnet – und welche Leitplanken dafür sorgen, dass am Ende trotzdem ein Mensch entscheidet.
· 7 Min. Lesezeit
KI-generiert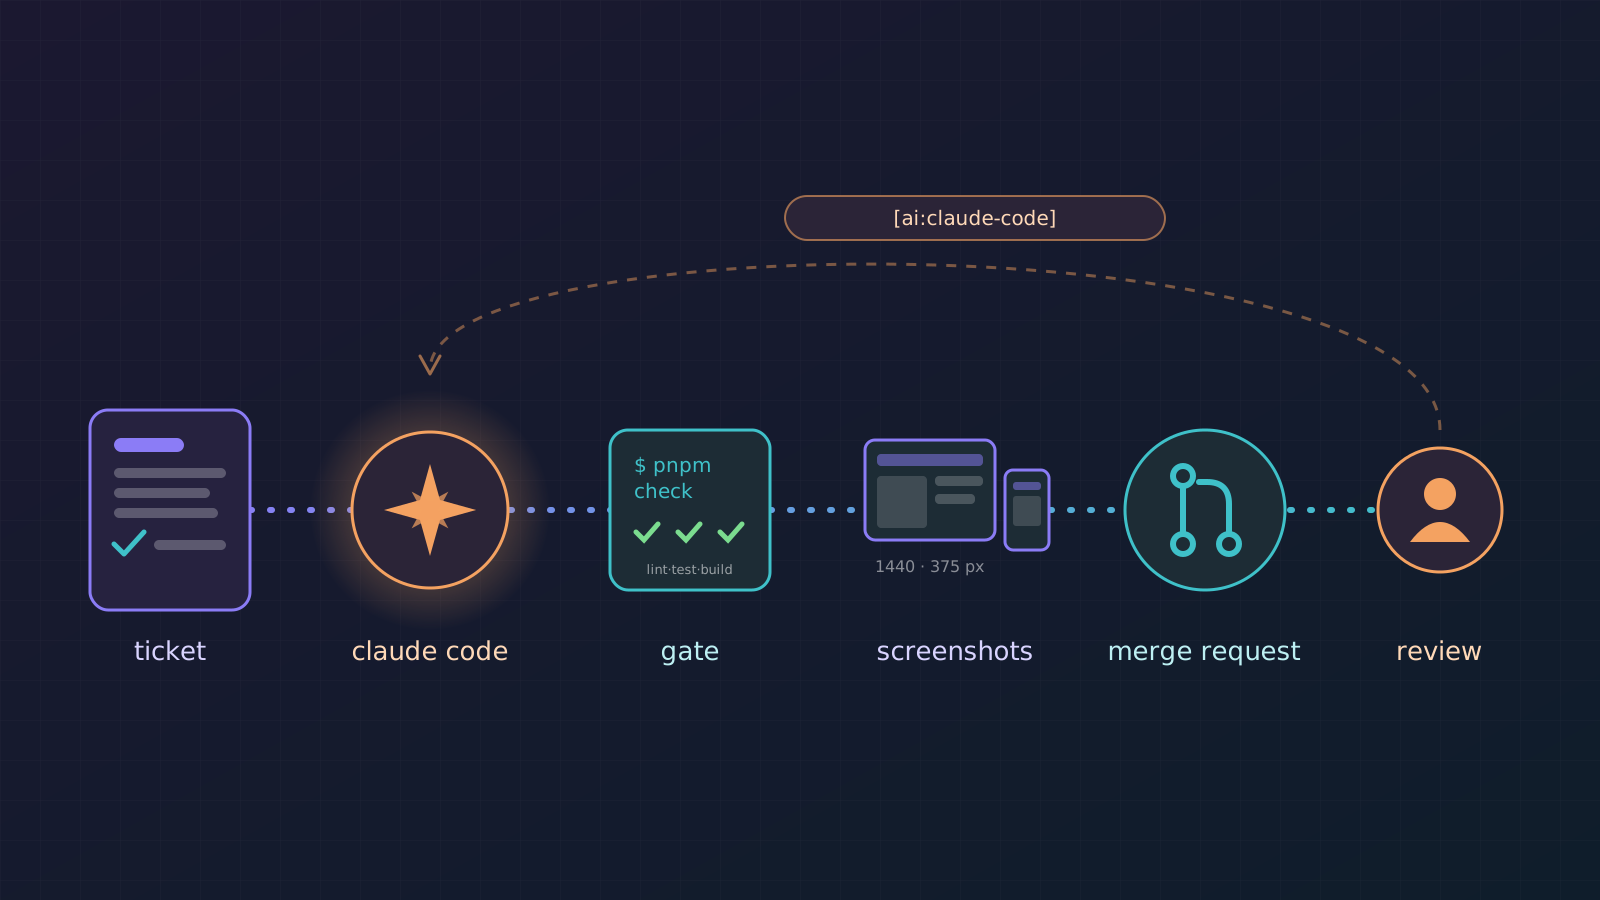
Hinweis: Auch dieser Beitrag wurde mit Claude geschrieben – aus dem Repository heraus, das er beschreibt – und über den MCP-Server dieser Website als Entwurf ins CMS gelegt.
Im letzten Beitrag ging es darum, wie diese Website gebaut und ausgeliefert wird. Diesmal geht es um ein grösseres Projekt – genauer gesagt nicht um das Projekt selbst, sondern um die Art, wie daran gearbeitet wird: Ein grosser Teil der Umsetzung läuft über Claude Code, eingebettet in eine Pipeline aus Jira, Git, CI und Reviews.
Die kurze Version: Die KI schreibt viel Code. Aber sie arbeitet in einem Korsett aus Regeln, Skripten und automatischen Checks, das so gebaut ist, dass Fehler auffallen, bevor sie gemergt werden – und dass fachliche Entscheide immer bei einem Menschen bleiben.
Der Rahmen
Technisch ist es ein Nx-Monorepo mit einem Angular-Frontend und einem NestJS-Backend. Die Anforderungen stehen in einem Dokument mit rund 250 nummerierten Punkten, der Backlog umfasst etwa 150 Epics und Stories. Gross genug also, dass man ohne Struktur schnell den Überblick verliert – als Mensch wie als KI.
Die Grundidee: Das Repo erklärt sich selbst
Das Herz des ganzen Setups ist unspektakulär: eine CLAUDE.md im Repo-Root. Claude Code liest sie bei jeder Sitzung automatisch. Inzwischen ist sie ein ziemlich dickes Dokument – und das ist Absicht.
Sie enthält nicht nur Stack und Befehle, sondern vor allem das Warum hinter Entscheiden:
- Warum der Nx-Daemon deaktiviert ist (sein Kaltstart dauerte unter Windows bis zu 31 Minuten).
- Warum
prisma db pushtabu ist (es hat einmal Testdaten gelöscht). - Warum Request-Scoped Provider in NestJS hier ein Fehler sind (CQRS-Handler sehen den Request nicht – das Symptom sah aus wie ein Login-Problem).
- Warum ein Pfad-Alias im Frontend wieder zurückgebaut wurde.
Jede dieser Regeln ist aus einem echten Fehler entstanden. Ein Modell, das nur «mach X nicht» liest, findet einen kreativen Weg drumherum. Eines, das den Grund kennt, erkennt auch die Variante, an die beim Schreiben der Regel niemand gedacht hat.
Für das Backend legt die CLAUDE.md zudem eine klare Schichtung fest: Controller → Service-Fassade → Command/Query-Bus → Handler → Repository-Port → Prisma-Adapter. Nichts ausserhalb des Persistenz-Ordners darf den ORM-Client importieren. Solche Regeln sind für eine KI fast wichtiger als für Menschen: Sie macht sonst einfach das, was im nächstgelegenen Code steht.
Slash-Commands: Workflows statt Prompts
Wiederkehrende Abläufe sind als Slash-Commands unter .claude/commands/ abgelegt – Markdown-Dateien, die einen ganzen Workflow beschreiben:
/ticket PROJ-123– ein Jira-Ticket vollständig abarbeiten./check-comments– offene menschliche Kommentare auf Tickets finden und einen Plan daraus machen./standup– den täglichen Standup aus Jira-Status und Git-Aktivität zusammenstellen./backlog-sync– den Backlog aus einer YAML-Datei nach Jira spiegeln.
Dazu kommen Skills (add-feature, add-ui-component) für das Scaffolding nach Projektkonvention, und ein Review-Subagent, der geänderten Frontend-Code gegen die Konventionen prüft, ohne selbst etwas zu ändern.
/ticket: der Weg eines Tickets
Der wichtigste Command ist /ticket. Er ist in fünf Phasen gegliedert, und keine darf übersprungen werden:
- Verstehen. Ticket lesen, Kommentare lesen, blockierende Tickets prüfen, die referenzierten Anforderungen im Requirements-Dokument nachschlagen. Widersprechen sich Ticket und Anforderung, gewinnt die Anforderung – und die Abweichung wird im Ticket kommentiert. Enthält das Ticket eine offene Frage: nicht raten, sondern nachfragen.
- Planen. Ein kurzer Plan als Ticket-Kommentar: betroffene Dateien, Migrationen, Endpoints, Testansatz. Ab 8 Story Points muss ich den Plan freigeben, bevor Code entsteht. Dann: Ticket auf «In Progress», Feature-Branch anlegen.
- Implementieren. Schema zuerst, dann Tests vor oder mit dem Code. Abnahmekriterien der Form «GEGEBEN … WENN … DANN …» werden eins zu eins zu Testfällen – die Zahlen im Ticket sind erwartete Werte, keine Beispiele.
- Verifizieren.
pnpm checkmuss grün sein. Dann wird jedes Abnahmekriterium einzeln beantwortet: erfüllt, teilweise, nicht erfüllt, nicht prüfbar. «Nicht geprüft» als «erfüllt» zu melden, ist explizit ein Fehlschlag. - Übergeben. Branch pushen, Merge Request eröffnen, Ticket mit Kriterienliste kommentieren und auf «QA» schieben.
Und dann gibt es eine Liste unter «Nie»: nie ein Ticket auf «Done» schieben, nie selbst mergen, nie nach main pushen, nie einen Test auskommentieren, damit etwas grün wird, nie ein Abnahmekriterium umformulieren, damit es passt. Die fachliche Abnahme macht ein Mensch.
Screenshots als Beweis
Eine Regel hat sich besonders bewährt: Jede sichtbare Änderung braucht Screenshots im Ticket – immer auf 1440 px und auf 375 px Breite. Ein Playwright-Skript fotografiert die Seite, ein zweites hängt die Bilder ans Jira-Ticket.
Der Grund ist Prüfbarkeit. «Formular sauber umgesetzt» kann niemand widerlegen, ein Bild schon. Der allererste Screenshot im Projekt zeigte auf Anhieb einen Fehler, der durchs Code-Review gerutscht war: Ein Formular zeigte schon im unberührten Zustand alle Validierungsfehler an.
Wichtig dabei: Claude muss sich jeden Screenshot selbst ansehen, bevor er angehängt wird. Ein leeres oder kaputtes Bild ist schlimmer als keines – es sieht aus wie ein Beweis.
Wer hat diesen Kommentar geschrieben?
Ein Problem, das ich unterschätzt hatte: Alles, was aus dem Repo nach Jira geschrieben wird, läuft über meinen Account. Autor und Avatar sind immer meine – egal, ob ich oder die KI den Text geschrieben hat.
Das ist nicht nur eine Frage der Transparenz. Claude liest Kommentare zurück, um neue Anweisungen aufzunehmen. Ohne Unterscheidung hätte es seine eigenen Statusberichte beim nächsten Durchlauf als frische Anweisungen eines Menschen gelesen – und danach gehandelt.
Die Lösung ist ein Marker, mit dem jeder KI-Kommentar beginnt:
🤖 **Claude Code** `[ai:claude-code]`Ein kleines Skript (comments.mjs) klassifiziert Kommentare damit als AI oder HUMAN, kann nur unbeantwortete menschliche Eingaben anzeigen und mit --scan alle offenen Tickets finden, auf denen noch jemand auf eine Antwort wartet. Kommentare von vor der Einführung des Markers erscheinen als HUMAN? mit Warnung – denn wie sich herausstellte, waren sämtliche «offenen» Kommentare auf fünf alten Tickets in Wahrheit Statusberichte von Claude selbst.
Was liegen bleibt, wird ein Ticket
Eine weitere Regel: Alles, was Claude bemerkt, aber bewusst nicht behebt, wird zu einem Jira-Ticket, bevor das aktuelle Ticket übergeben wird. Ein Befund, der nur in einem Kommentar oder einem TODO steht, ist in zwei Wochen verschwunden.
Ein Skript legt das Folgeticket an, verlinkt es und schiebt es direkt in «To Do». Letzteres ist kein Detail: Jira legt neue Issues im Startstatus an, und der entspricht auf unserem Board der Backlog-Spalte, die niemand triagiert. Ein Folgeticket dort wäre genauso verloren wie ein Kommentar.
Ausserdem gibt es eine docs/tickets.md, die den aktuellen Jira-Stand spiegelt, damit spätere Sitzungen (und /standup) wissen, was gerade offen ist. Sie muss bei jeder Statusänderung im selben Durchgang nachgeführt werden – nachdem sie einmal über eine Woche hinweg still veraltet war und dreizehn Tickets als «QA» führte, die längst erledigt waren.
Backlog als Code
Der Backlog lebt nicht in Jira, sondern in einer backlog.yaml im Repo. Ein Sync-Skript spiegelt sie idempotent nach Jira: Epics vor Stories, erkennt bestehende Issues an einem Label, fasst Status, Assignees und Kommentare nie an und löscht nie etwas.
Das hat einen ganz praktischen Grund: Rund 150 Tickets über einzelne MCP-Toolaufrufe anzulegen, kostet ein Vielfaches an Tokens gegenüber einem einzigen Skriptaufruf. Für einzelne Tickets, bei denen Urteilsvermögen gefragt ist, nutzt Claude dagegen weiterhin den Atlassian-MCP direkt.
Die Pipeline: ein Befehl, zwei CI-Systeme
Das Quality Gate ist ein einziger Befehl: pnpm ci:verify – Lint, Warnungsbudget, Formatierung, alle Unit-Tests und alle Builds. pnpm check ist ein Alias dafür. Lokal, bei Claude und in der CI läuft also exakt dasselbe. Dazu kommt pnpm ci:integration für die Tests, die eine echte PostgreSQL-Datenbank brauchen – also alles, was Mocks nicht beweisen können, etwa dass Daten sauber voneinander getrennt bleiben.
Die Regel dazu: Neue Checks kommen immer in package.json, nie nur in eine CI-Datei. Sonst prüfen zwei CI-Systeme irgendwann still verschiedene Dinge.
Zwei CI-Systeme, weil das Projekt umgezogen ist: GitLab ist inzwischen die Quelle der Wahrheit – Merge Requests, Build, Docker-Images, Deployment per Tag. GitHub ist nur noch ein Push-Spiegel. Das war nötig, weil das Gate vor dem Merge laufen muss, und die einzige Pipeline, die zuverlässig lief, war die auf GitLab. Der /ticket-Command wurde entsprechend forge-unabhängig gemacht: Ob ein Pull Request oder ein Merge Request entsteht, entscheidet allein, wohin origin zeigt.
Der Linter als Signal
ESLint-Warnungen lassen CI nicht fehlschlagen. Das heisst, ihre Zahl kann nur wachsen – und sie ist gewachsen, auf 49 im Backend, ohne dass es jemand gemerkt hätte.
Jetzt gibt es eine .eslint-budget.json mit einer Obergrenze pro Projekt und ein Skript, das sie im Gate prüft. Die Zahl darf nur sinken: Wer Warnungen behebt, senkt das Budget im selben Merge Request. Wer es erhöht, um einen roten Check grün zu bekommen, fällt auf. Das Backend steht inzwischen bei 25.
Gerade mit einer KI im Team ist so ein Ratchet Gold wert: Sie hat keine Hemmung, eine Warnung zu ignorieren, wenn der Build trotzdem grün ist.
Was ich dabei gelernt habe
- Regeln brauchen Begründungen. Die besten Abschnitte der
CLAUDE.mderzählen kurz, was schiefgelaufen ist. Das verhindert nicht nur denselben Fehler, sondern auch seine Verwandten. - Prosa ist kein Nachweis. Screenshots, Testfälle aus Abnahmekriterien und eine Kriterienliste mit «nicht geprüft» sind ehrlicher als jede Zusammenfassung.
- Provenienz ist kein Nice-to-have. Sobald ein Agent seine eigenen Texte zurückliest, muss er sie erkennen können.
- Was nicht im Ticket steht, existiert nicht. Das gilt für Menschen, und für eine KI ohne Gedächtnis zwischen Sitzungen erst recht.
- Die KI macht keine Abnahme. Sie setzt um, testet und berichtet. Ob etwas fachlich stimmt – gerade bei Rechenlogik – prüft ein Mensch, und Claude nennt dafür am Ende die Testfälle, die man gegenrechnen soll.
Fazit
Der grösste Hebel war nicht ein besonders cleverer Prompt, sondern Infrastruktur um das Modell herum: ein Repo, das sich selbst erklärt, Workflows als Dateien, Skripte für alles Mechanische und ein Gate, das niemand umgehen kann – auch die KI nicht. Innerhalb dieses Rahmens ist Claude Code ein erstaunlich verlässliches Teammitglied. Ausserhalb davon wäre es einfach nur schnell.